橫跨 NVIDIA Vera CPU、Rubin GPU、NVLink 6 交換器、ConnectX-9 SuperNIC、BlueField-4 DPU 與 Spectrum-6 乙太網路交換器的極致協同設計,可大幅縮短訓練時間並降低推論詞元生成成本。
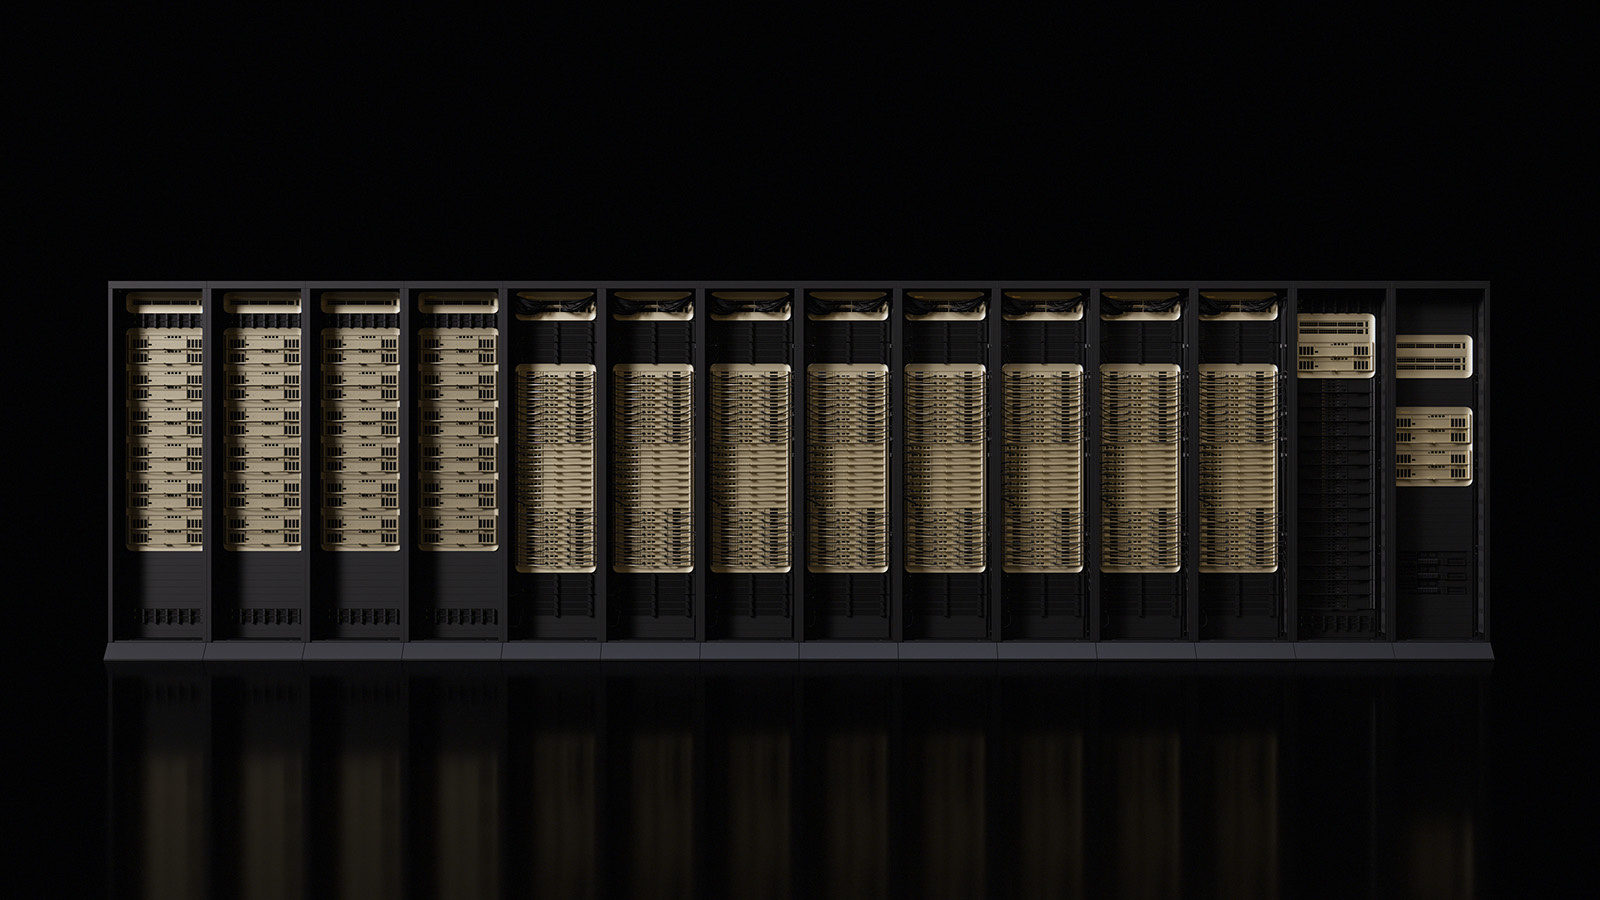
CES——NVIDIA 今日正式開啟新一代 AI,發表由六款全新晶片組成、用以打造一部出色的 AI 超級電腦的 NVIDIA Rubin 平台。NVIDIA Rubin 為建置、部署與保護全球規模最大、最先進的 AI 系統樹立新標竿,並以最低成本加速主流 AI 的普及。
Rubin 平台的六款晶片採用極致協同設計,包含 NVIDIA Vera CPU、NVIDIA Rubin GPU、NVIDIA NVLink™ 6 交換器、NVIDIA ConnectX®-9 SuperNIC、NVIDIA BlueField®-4 DPU 與 NVIDIA Spectrum™-6 乙太網路交換器,以大幅縮短訓練時間並降低推論詞元(token)成本。
「Rubin 的問世恰逢其時,因為 AI 運算在訓練與推論上的需求正呈現爆炸性成長,」NVIDIA 創辦人暨執行長 Jensen Huang 表示。「憑藉我們每年交付新一代 AI 超級電腦的節奏——以及橫跨六款全新晶片的極致協同設計——Rubin 正朝 AI 的下一個前沿邁出巨大的一步。」
以開創性的美國天文學家 Vera Florence Cooper Rubin 命名——她的發現改變了人類對宇宙的理解——Rubin 平台具備 NVIDIA Vera Rubin NVL72 機架級解決方案與 NVIDIA HGX Rubin NVL8 系統。
Rubin 平台導入五項創新,包括最新一代的 NVIDIA NVLink 互連技術、Transformer Engine、機密運算與 RAS Engine,以及 NVIDIA Vera CPU。這些突破將加速代理型 AI、進階推理,以及大規模混合專家(MoE)模型推論,每個詞元的成本相較 NVIDIA Blackwell 平台最多可降低 10 倍。與前代相比,NVIDIA Rubin 平台訓練 MoE 模型所需的 GPU 數量減少 4 倍,以加速 AI 的採用。
廣泛的生態系支援
全球領先的 AI 實驗室、雲端服務供應商、電腦製造商與新創公司中,預期採用 Rubin 的包括 Amazon Web Services(AWS)、Anthropic、Black Forest Labs、Cisco、Cohere、CoreWeave、Cursor、Dell Technologies、Google、Harvey、HPE、Lambda、Lenovo、Meta、Microsoft、Mistral AI、Nebius、Nscale、OpenAI、OpenEvidence、Oracle Cloud Infrastructure(OCI)、Perplexity、Runway、Supermicro、Thinking Machines Lab 與 xAI。
OpenAI 執行長 Sam Altman:「智慧隨運算而擴展。當我們增加更多運算,模型就會更有能力、解決更難的問題,並為人們帶來更大的影響。NVIDIA Rubin 平台幫助我們持續擴展這項進展,讓先進智慧惠及每一個人。」
Anthropic 共同創辦人暨執行長 Dario Amodei:「NVIDIA Rubin 平台的效率提升,正是實現更長記憶、更好推理與更可靠輸出所需的那種基礎設施進展。我們與 NVIDIA 的合作,有助於推動我們的安全研究與前沿模型。」
Meta 創辦人暨執行長 Mark Zuckerberg:「NVIDIA 的 Rubin 平台可望帶來效能與效率的躍升,這正是把最先進模型部署給數十億人所需要的。」
xAI 創辦人暨執行長 Elon Musk:「💚🎉🚀 🤖NVIDIA Rubin 將成為 AI 的火箭引擎。若你想大規模訓練並部署前沿模型,這就是你該使用的基礎設施——而 Rubin 會再次提醒世界,NVIDIA 就是黃金標準。💚🎉🚀 🤖」
Microsoft 執行董事長暨執行長 Satya Nadella:「我們正在打造全球最強大的 AI 超級工廠,以最高效能與效率,在任何地方服務任何工作負載。加入 NVIDIA Vera Rubin GPU 之後,我們將使開發人員與組織能以全新的方式創造、推理與擴展。」
CoreWeave 共同創辦人暨執行長 Mike Intrator:「我們創立 CoreWeave,是為了藉由專為 AI 打造的平台所具備的無可比擬效能,協助先驅者加速創新,並隨著工作負載演進,為其匹配正確的技術。NVIDIA Rubin 平台是推理、代理型與大規模推論工作負載的重要進展,我們很高興將它納入我們的平台。以 CoreWeave Mission Control 作為營運標準,我們可以快速整合新能力,並在生產規模上可靠地運作,同時與 NVIDIA 緊密合作。」
AWS 執行長 Matt Garman:「AWS 與 NVIDIA 攜手推動雲端 AI 創新已超過 15 年。AWS 上的 NVIDIA Rubin 平台,代表我們持續承諾提供尖端 AI 基礎設施,為客戶帶來無與倫比的選擇與彈性。結合 NVIDIA 先進的 AI 技術,以及 AWS 經證實的規模、安全性與完整的 AI 服務,客戶能更快速、更具成本效益地建置、訓練與部署要求最高的 AI 應用——加速他們從實驗邁向任何規模正式生產的腳步。」
Google 與 Alphabet 執行長 Sundar Pichai:「我們對與 NVIDIA 深厚且長久的關係感到自豪。為了滿足我們所見客戶對 NVIDIA GPU 的大量需求,我們專注於在 Google Cloud 上為其硬體提供最佳的運作環境。我們的合作將持續下去,把 Rubin 平台出色的能力帶給客戶,提供他們推進 AI 邊界所需的規模與效能。」
Oracle 執行長 Clay Magouyrk:「Oracle Cloud Infrastructure 是為最高效能而打造的超大規模雲端,我們與 NVIDIA 一起,正在突破客戶能以 AI 建置與擴展的邊界。藉由 NVIDIA Vera Rubin 架構所驅動的超大規模(gigascale)AI 工廠,OCI 為客戶提供突破模型訓練、推論與真實世界 AI 影響力極限所需的基礎設施基礎。」
Dell Technologies 董事長暨執行長 Michael Dell:「NVIDIA Rubin 平台代表 AI 基礎設施的重大躍進。透過將 Rubin 整合進 Dell AI Factory with NVIDIA,我們正在打造能夠處理巨量詞元與多步驟推理的基礎設施,同時提供企業與新型雲端大規模部署 AI 所需的效能與韌性。」
HPE 總裁暨執行長 Antonio Neri:「AI 正在重塑的不只是工作負載,還有 IT 的根本基礎,這要求我們從網路到運算,重新構想基礎設施的每一層。藉由 NVIDIA Vera Rubin 平台,HPE 正在打造新一代安全、AI 原生的基礎設施,將資料轉化為智慧,並使企業成為真正的 AI 工廠。」
Lenovo 董事長暨執行長 Yuanqing Yang:「Lenovo 正擁抱新一代 NVIDIA Rubin 平台,運用我們的 Neptune 液冷解決方案,以及全球規模、製造效率與服務觸及範圍,協助企業打造 AI 工廠,作為洞察與創新的智慧加速引擎。我們正共同構築由 AI 驅動的未來,讓高效且安全的 AI 成為每個組織的標準。」
為擴展智慧而設計
代理型 AI 與推理模型,加上最先進的影片生成工作負載,正在重新定義運算的極限。多步驟問題解決要求模型在長序列詞元之間進行處理、推理與行動。為了滿足複雜 AI 工作負載的需求,Rubin 平台的五項突破性技術包括:
第六代 NVIDIA NVLink:提供當今大規模 MoE 模型所需、快速且無縫的 GPU 對 GPU 通訊。每顆 GPU 提供 3.6TB/s 的頻寬,而 Vera Rubin NVL72 機架提供 260TB/s——比整個網際網路的頻寬還高。憑藉內建的網路內運算以加速集合運算,以及強化可維護性與韌性的新功能,NVIDIA NVLink 6 交換器能在規模上實現更快速、更有效率的 AI 訓練與推論。
NVIDIA Vera CPU:專為代理型推理而設計,NVIDIA Vera 是大型 AI 工廠最節能的 CPU。這顆 NVIDIA CPU 採用 88 個 NVIDIA 客製化 Olympus 核心,完整相容於 Armv9.2,並具備超高速的 NVLink-C2C 連接能力。Vera 提供卓越的效能、頻寬與業界領先的效率,以支援全方位的現代資料中心工作負載。
NVIDIA Rubin GPU:搭載具備硬體加速自適應壓縮的第三代 Transformer Engine,為 AI 推論提供 50 petaflops 的 NVFP4 運算能力。
第三代 NVIDIA 機密運算:Vera Rubin NVL72 是首款提供 NVIDIA 機密運算的機架級平台——可在 CPU、GPU 與 NVLink 網域之間維持資料安全——保護全球最大型的專有模型,以及訓練與推論工作負載。
第二代 RAS Engine:Rubin 平台涵蓋 GPU、CPU 與 NVLink,具備即時健康檢查、容錯與主動維護,以最大化系統生產力。機架採用模組化、無纜線托盤設計,組裝與維修速度最多可比 Blackwell 快上 18 倍。
AI 原生儲存與安全的軟體定義基礎設施
NVIDIA Rubin 推出 NVIDIA Inference Context Memory Storage Platform(NVIDIA 推論情境記憶儲存平台),這是一類全新的 AI 原生儲存基礎設施,旨在以超大規模(gigascale)擴展推論情境。
由 NVIDIA BlueField-4 驅動,此平台能在 AI 基礎設施之間有效共享並重複使用鍵值快取(key-value cache)資料,提升回應能力與輸送量,同時讓代理型 AI 以可預期、節能的方式擴展。
隨著 AI 工廠日益採用裸機與多租戶部署模式,維持強大的基礎設施控管與隔離變得不可或缺。
BlueField-4 亦導入 Advanced Secure Trusted Resource Architecture(ASTRA,先進安全可信任資源架構)。這是一種系統層級的信任架構,為 AI 基礎設施建置者提供單一且受信任的控制點,以便在不犧牲效能的前提下,安全地佈建、隔離並營運大規模 AI 環境。
隨著 AI 應用朝多回合代理型推理演進,AI 原生組織必須在使用者、工作階段與服務之間,管理並共享遠比以往更多的推論情境。
因應不同工作負載的不同型態
NVIDIA Vera Rubin NVL72 提供一套統一且安全的系統,結合 72 顆 NVIDIA Rubin GPU、36 顆 NVIDIA Vera CPU、NVIDIA NVLink 6、NVIDIA ConnectX-9 SuperNIC 與 NVIDIA BlueField-4 DPU。
NVIDIA 亦將提供 NVIDIA HGX Rubin NVL8 平台。這是一塊伺服器主機板,透過 NVLink 連結八顆 Rubin GPU,以支援以 x86 為基礎的生成式 AI 平台。HGX Rubin NVL8 平台可加速 AI 與高效能運算工作負載的訓練、推論與科學運算。
NVIDIA DGX SuperPOD™ 可作為大規模部署以 Rubin 為基礎之系統的參考,整合 NVIDIA DGX Vera Rubin NVL72 或 DGX Rubin NVL8 系統,以及 NVIDIA BlueField-4 DPU、NVIDIA ConnectX-9 SuperNIC、NVIDIA InfiniBand 網路與 NVIDIA Mission Control™ 軟體。
新一代乙太網路
先進的乙太網路與儲存是 AI 基礎設施的關鍵組成,對於讓資料中心維持全速運作、提升效能與效率,以及降低成本至關重要。
NVIDIA Spectrum-6 乙太網路是 AI 網路的新一代乙太網路,為以更高效率與更強韌性擴展以 Rubin 為基礎的 AI 工廠而打造,並藉由 200G SerDes 通訊電路、共同封裝光學元件與 AI 最佳化網狀架構來實現。
以 Spectrum-6 架構為基礎的 Spectrum-X 乙太網路光子學共同封裝光學交換器系統,相較傳統方法,可為 AI 應用帶來 10 倍更高的可靠性,並將正常運作時間延長 5 倍,同時達到 5 倍更佳的能源效率,將每瓦效能發揮到最大。Spectrum-XGS 乙太網路技術屬於 Spectrum-X 乙太網路平台的一部分,能讓相隔數百公里甚至更遠的設施如同單一 AI 環境般運作。
這些創新共同定義了新一代 NVIDIA Spectrum-X 乙太網路平台。它以極致協同設計為 Rubin 打造,支援大規模 AI 工廠,並為未來的百萬 GPU 環境鋪路。
Rubin 就緒
NVIDIA Rubin 已全面量產,以 Rubin 為基礎的產品將於 2026 年下半年由合作夥伴供應。
2026 年首批部署以 Vera Rubin 為基礎之執行個體的雲端供應商,將包括 AWS、Google Cloud、Microsoft 與 OCI,以及 NVIDIA 雲端合作夥伴 CoreWeave、Lambda、Nebius 與 Nscale。
Microsoft 將部署 NVIDIA Vera Rubin NVL72 機架級系統,作為新一代 AI 資料中心的一部分,包括未來的 Fairwater AI 超級工廠場地。
Rubin 平台旨在為訓練與推論工作負載提供前所未有的效率與效能,並將成為 Microsoft 新一代雲端 AI 能力的根基。Microsoft Azure 將提供高度最佳化的平台,讓客戶加速企業、研究與消費性應用的創新。
CoreWeave 將自 2026 年下半年起,把以 NVIDIA Rubin 為基礎的系統整合進其 AI 雲端平台。CoreWeave 的設計能讓多種架構並行運作,使客戶將 Rubin 引進自身環境,並在訓練、推論與代理型工作負載上發揮最大影響力。
CoreWeave 將與 NVIDIA 一起,協助 AI 先驅善用 Rubin 在推理與 MoE 模型上的進展,同時在完整生命週期中,持續以 CoreWeave Mission Control 提供生產環境 AI 所需的效能、營運可靠性與規模。
此外,Cisco、Dell、HPE、Lenovo 與 Supermicro 預計將推出多種以 Rubin 產品為基礎的伺服器。
包括 Anthropic、Black Forest、Cohere、Cursor、Harvey、Meta、Mistral AI、OpenAI、OpenEvidence、Perplexity、Runway、Thinking Machines Lab 與 xAI 在內的 AI 實驗室,正寄望 NVIDIA Rubin 平台來訓練更大、能力更強的模型,並以比前幾代 GPU 更低的延遲與成本,提供長情境、多模態系統的服務。
基礎設施軟體與儲存合作夥伴 AIC、Canonical、Cloudian、DDN、Dell、HPE、Hitachi Vantara、IBM、NetApp、Nutanix、Pure Storage、Supermicro、SUSE、VAST Data 與 WEKA,正與 NVIDIA 合作,為 Rubin 基礎設施設計新一代平台。
Rubin 平台標誌著 NVIDIA 的第三代機架級架構,並有超過 80 家 NVIDIA MGX™ 生態系合作夥伴。
為了釋放這樣的密度,Red Hat 今日宣布擴大與 NVIDIA 的合作,透過 Red Hat 的混合雲產品組合,提供針對 NVIDIA Rubin 平台最佳化的完整 AI 堆疊,包括 Red Hat Enterprise Linux、Red Hat OpenShift 與 Red Hat AI。這些解決方案已被絕大多數《財星》全球 500 大企業採用。